

在上一篇,我們談了「盤查標的」與「PCR」。今天我們要正式面對碳足跡盤查中最耗時的環節:數據蒐集、分配與計算。
碳足跡的計算公式其實很簡單:假設共使用1公升的油,每公升的油會排放1公斤的二氧化碳,那是不是相乘就可以得到排放量? 這也是最常使用的方式,我們稱為排放係數法,但這個問題就是係數去哪裡找,找到了也要確認能不能用,因此看起來很簡單,但實務上還有很多細節需要注意,本篇就是跟大家介紹這些細節。
步驟四:計算方法
首先就是介紹計算方法了,實務上主要分成三種
1. 排放係數法:排放量 = 活動數據 × 排放係數
就是開頭講的那個舉例,假設總共使用了100公升的油,排放係數是每公升油排1公斤當量二氧化碳,所以總共就是排放100 x 1等於 100公斤二氧化碳,把用量成以系數直接得到答案,這是最多人使用的方法,只要你能找到係數就能算,至於怎麼找到係數那是另一個問題了,下面會介紹。
2. 直接監測法:直接裝個測量儀器,去監測排了多少二氧化碳,這很直覺但很麻煩且昂貴,實務上非常少用。
3. 質量平衡法:這方法就是國高中學的「化學方程式」
>>例如:CaCO3 --> CaO + CO2
這個方程式,國高中化學都學過
投入1 kg的碳酸鈣原料,會得到0.56 kg的生石灰產品,和0.44 kg的二氧化碳
以前國高中在學的時候可能要算CaO有多少,但現在我們反而要算CO2有多少,概念是一樣的。
實際上使用頻率:排放係數法>>質量平衡法>>直接監測法,除非你是半導體或化學工廠,不然一般都是使用排放係數法居多,但公式簡單,不代表過程輕鬆,實際下去要做會發現裡面藏著無數個讓新手顧問或企業承辦人崩潰的大大大地雷,所以接下來我們就來看看操作上時常會碰到那些問題。
步驟五:活動數據蒐集
在蒐集數據時,請牢記一個最高原則:「只要工廠有花錢的,通通都要算進去。」
當然沒花錢的可能也要算,但只要有花錢的幾乎是100%都要算的,所以盤查時候可能會需要與公司的財務部門高度合作。
1. 用「生命週期」的思維去找數據
無論你使用哪一種計算方法,逃不掉的就是蒐集活動數據,至於要怎麼蒐集,上一篇文有說要根據PCR繪製屬於自己的製程地圖,那其實就是用來讓自我思考有哪些排放源用的,看著地圖實際到工廠走一圈,把看到的都記錄下來就變成排放源了,至於會不會漏看....新手的話一定會,但多做幾次就會慢慢變少了。
最後你會得出一個自己的排放源列表
例如原料:鐵100公斤、鋁300公斤、油500公升、包裝100個紙箱...等
其他製造、配銷、使用、廢棄也是同樣的邏輯,而這個整理出來的列表,項目是你的排放源,數字是你的活動數據。
2. 佐證資料&延伸資料一併蒐集
一般新手在做碳足跡的時候,很常去工廠問數據,拿到當年度共採購「鋼鐵 1000 公斤」就開心地走了。結果回來要計算時才發現,根本算不下去,或者算完了,結果查證也不會過!
為什麼這樣呢?因為這是新手最常犯的問題,索取數據時候一定要將相關級延伸資料都給問到,比如說:
原料: 首先這 1000 公斤鋼鐵,查證員會問你如何證明是1000公斤,是採購單上寫的,那你的證明就是採購單,所以你不是跟財務問到1000公斤這個數字紀錄後就走了,是要跟他要到採購單,然後拍照也好、掃描、要完整檔案也好,總之檔存下來並找個資料夾放好,這才是你的證明文件,而不是你excel或紙上記錄的1000公斤。
製造: 這 1000 公斤的鋼鐵,最終用在你的標的產品共多少公斤?同上佐證在哪裡?假設這1000公斤最終有100公斤拿去做我們這次盤查的產品,那100公斤是你預估的還是有機台數據佐證?沒有的話要想辦法找到,因為這牽涉到下一步驟要介紹的「分配」。
運輸:運輸就是最要注意的,上面說的鐵、鋁、油、紙箱...等,幾乎可以說「你有幾個排放源就有幾個運輸項目」,除了鐵本身的排放外,鐵運到你這邊也有排放,而他們其實是兩個不同排放源,鐵之外的其他鋁、油、紙箱等各項也都有一個運輸的排放源,他們都是獨立的。
而這運輸,要順便蒐集的是怎麼運來的,用什麼類型的車子,地點多遠。
例如1000公斤的鋼鐵是大貨車還小貨車運來的? 因為他引用的係數不同,而假設是大貨車送貨好了,你要也證明是大貨車送貨的,所以你要在他送貨時,拍一張照片當佐證才能證明這個鐵的原料確實是大貨車送的。
另外就是距離了部份了,很多人會把對方工廠到自己工廠的距離上google map上一查,顯示10公里,就很高興紀錄後就關掉網頁了,但查證員問你10公里可有證據的時候,會發現網路再查一次變成10.3公里了,之後影響不只是查證會被開缺失,這一個數據改了牽一髮動全身,你的報告書可能要地毯式的搜尋大量修改、無論是表格、圖表、圓餅圖、比例說明,都會連動影響到。
因此都會建議去產線訪談時,盡量一次把所有相關資料都問齊,才不會事後狂打電話被公司/工廠 同事嫌煩。
3. 蒐集優先順序
一級數據(直接獲得的第一手數據) > 二級數據(間接獲得得二手數據)
除了PCR會要求某些項目一定要一級數據外,可以使用二級數據的也不要高興太早,在可能的範圍內也盡量使用一級數據,即使PCR沒有規定,但查證員最終可能還是會認為某些活動數據並非難以取得的數據,要求你需要提供直接測量的一級數據,為此你可能要花好幾千塊裝電表都是有可能的,與其事後再來補不如一開始就不要耍小聰明。
另外即使真的決定要使用二級數據,無論是文獻數據、隔壁工廠/同行的數據,又或者透過合理假設而來的數字,在報告書都要寫清楚,尤其假設的部分,且優先使用順序也要注意,可以的話盡量找到文獻佐證,雖然可以合理假設,但原則上是盡量不要假設,你以查證員的視角來看,你每假設一個東西查證員就多一個風險,那會被查證員質疑也無可厚非對吧。
舉例來文獻資料:
a. 完全文獻:根據經濟部XXXX作業要點,工廠員工生活用水為XX公升/每人
>>這就是優先使用的二級數據,文獻選用順序,以經驗來說查證員青睞順序:政府公開資料>國際權威組織碳相關文獻(如何聯合國組織)>>>論文文獻>一般NGO組織的報告>>>網路一般文章
b. 基於文獻假設:例如找到XXX資料顯示台灣人每天使用3公斤垃圾,假設只有1/3時間在工廠,所以工廠只有會產生1公斤的生活垃圾。
c. 完全假設數據:我們假設每次保養機台會用10cc/次的潤滑油,但沒有資料證明。
>>這種完全假設,最好的方式就還是搜尋看看有沒有相關論文或資料可以證明,在怎麼薄弱也比你完全自己假設好,除非你可以說服查證員這個真的找不到,只能基於經驗假設,而且查證員也不一定肯保證,所以盡可能少用。
步驟六:分配
這是整本清冊中最容易算錯,也是最難的的地方,它同時也是市面上一堆軟體廠商賣14064的軟體,卻很少有14067的軟體(即使有也很難用)的根本原因,而造成「產品」碳盤查比「組織」碳盤查更難好幾倍的原因,這原因就是本章節的「分配」,每個項目的分配都是特殊/客製化的,而且邏輯都是要想清楚過的,而分配是指當好幾個產品共用同一個資源(如總電表)時,你要用什麼依據把碳排「分 / 拆」給你的盤查標的?而且幾乎是「每一項」排放源都會需要分配。
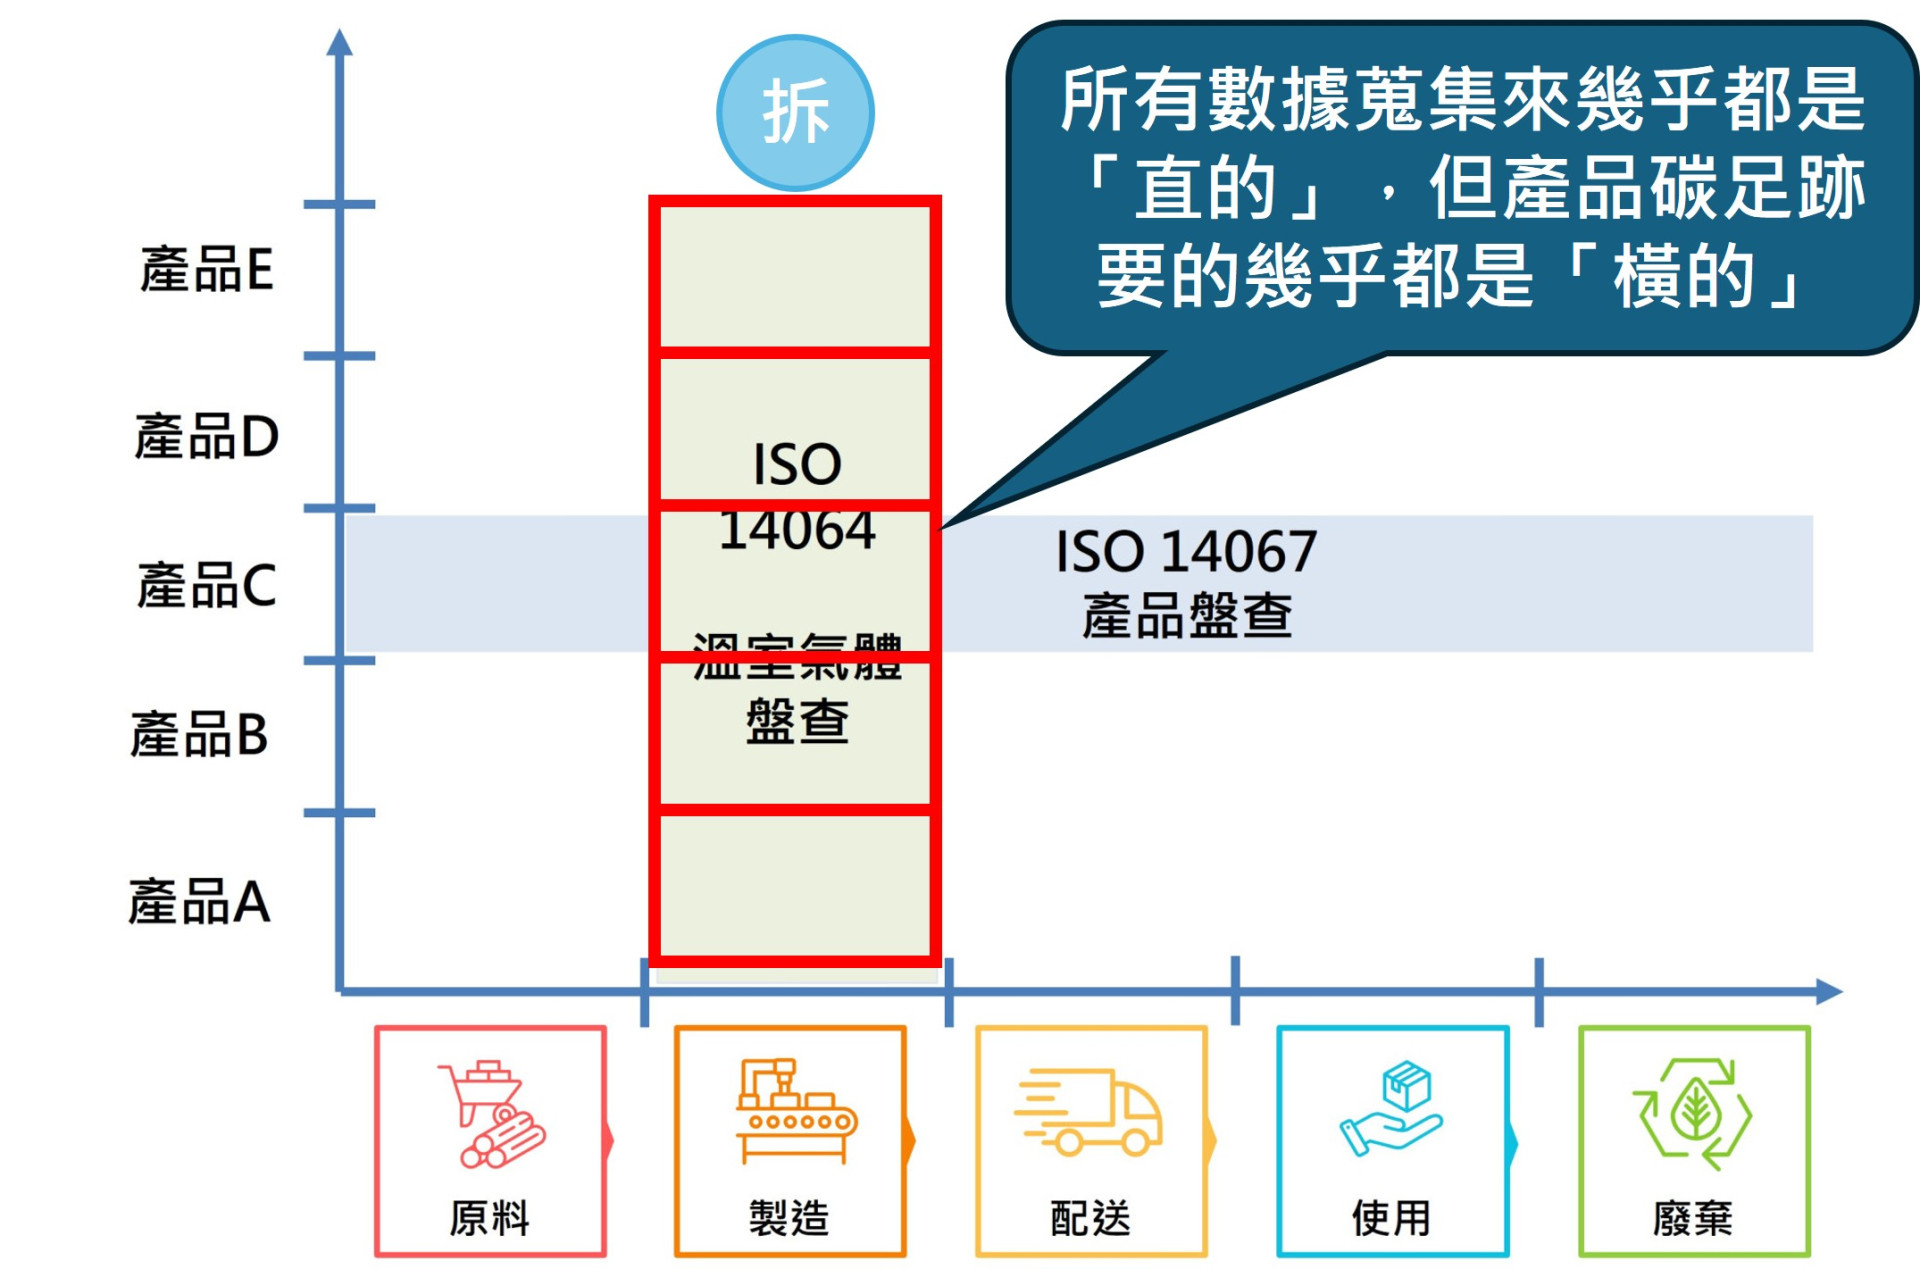
舉例來說假設今天採購單是100公斤的鐵
A產線使用25公斤鐵(25%)
B產線使用35公斤鐵(35%)
C產線使用40公斤鐵(40%)
這時候活動數據如果是100公斤,那A產線分配就是25%的比例,最後計算就是25公斤去乘系數算出碳排,而想當然的,上一步驟講的佐證又來了,這25%的佐證是什麼有沒有紀錄,如果沒有可以證明鐵是25%的佐證資料那就麻煩了。
而上面只是比較簡單的舉例,有些東西不一定適合用重量去分配,比方說電力,今天同樣是製造100公斤的鐵,使用100度電,那A產線用的電力卻不一定是25度,機台可能不同,條狀的鐵跟塊狀的鐵可能使用不同機台,那他們的耗電率不會一樣,此外如果條狀的用人搬運就好,而塊狀的要用機器搬,那就更不能直接用重量了。
因此從原料到最後產出,要怎麼合理分配就是需要仔細思考與仔細查閱PCR是否有相關規範的問題,而這通常也是最常被查證員質疑算錯的地方。
總之分配是個需要仔細好好思考的問題,一般常見的分配原則有:重量、體積、時間、經濟價值等,優先使用物理分配,真的沒辦法經濟價值是最後的下下策,但經濟分配查證員極度不愛,甚至可能會不敢保證,記得一定要優先盡使用物理性質的分配。
1. 分配到哪裡?
比如說今天蘿蔔食品工廠的原料蘿蔔,農民種植時候使用100公斤的肥料,假設這肥料要計算,且要分配下去,那最後要分配到哪裡呢?
舉例:說這100公斤肥料,農民用來生產1000公斤蘿蔔跟500公斤的玉米,其中的蘿蔔30%賣給農會,其他70%賣給其他人,而工廠又跟農會買其中的50%當原料,這個原料會拿來製造ABCDE產品,其中A產品佔20%,最後生產了1000個A產品。
那這100公斤的肥料是分配到哪裡?是分配到製造工廠?還是分配到產線?還是分配到每一個產品?這是所有剛盤查時候大家都會碰到的疑問,看到計算公式覺得很簡單,真的要算也算得出來,但要填到清冊上時卻發現填不出來。
而這題答案是,分配到產線A上面,而不是產品,雖然最後我們要算的是每一個產品多少碳排,但實務上分配時候不是直接分配到產品上面,是把所有(包括鐵、鋁、油、紙箱...等)統一分配到產線A上面,再由產線A總共生產1000個產品,每個產品1公斤,去分別得到一個產品&每一公斤產品的排放。
2. 原始活動數據選用
假設工廠發票顯示用了 10 公升汽油,你的 A 產品產線分配到 30%(3 公升)。
思考一下這時候你在清冊上面的活動數據要寫10公升還是3公升的汽油?
答案是10公升的汽油,因為你「最原始的數字」是買油的發票,而佐證上面的數字就是你的活動數據,至於產品線分配30%那是另一個佐證資料,雖然最後算出來的碳排數字也沒錯,但實務上你的活動數據就是你擁有證據的那個數據源,即是加油發票。
不過如果真的要使用3公升當活動數據可不可以?答案是也可以,如果你有一個監控設備,會持續監控每個產線的油量使用量,而這個你自己監測收集的資料就是一級數據,優先使用的程度甚至高於發票,例如儀器設備數據顯示A產線共使用了3公升的汽油,由於3公升不是事後又透過時間或重量分配來的,那直接測量的數據就可以當活動數據用。
3. 分配原則的「一致性」
這是一個實務上非常容易踩到,但又看似「邏輯正確」的陷阱,一致性在很多地方都用的到,不過用的到的地方一般人都可以預期,比方說不同年份要比較是不是要有一致性才有可比性,這都好理解,但比較可能漏掉的其實是在分配原則也要遵守。
比方說某專門生產切塊蘿蔔的工廠,依照 PCR(產品類別規則)規範,製程分為:冷藏保存、製造(切塊)、二次清洗、包裝、冷凍等步驟。針對「製造(切塊)」這道工序,廠內只有一個總電表記錄這個步驟的總用電,卻沒有細分到每個商品的產線,所以需要分配。
為了解算出各項產品的用電,負責人看前段的清洗、削皮、運輸,無論哪種產品做法都一樣,決定先用產出的「重量分配」來算電數;但到了後段的切塊,因為不同尺寸的產品會使用不同機台、耗時不同,於是決定改用「時間 + 機台耗電」去推算度數。
也就是說,因為同一個步驟裡,前半段大家做法一樣、後半段不一樣,負責人就把這顆「製造(切塊)」這個項目自己拆成兩半來算:前面使用重量分配最直接快速,後面使用時間分配,最後把兩邊相加,精準算出每個產線的用電量。這在數學邏輯上聽起來完全合理對吧?
但如果你這麼做,大概率會被查證員直接退貨!
原因在於:同一個排放源項目(同一顆電表或同一個宣告步驟),不能同時混用兩種不同的分配原則。 只要是共用同一個數據來源,就必須維持一致。當你知道這個步驟的後半段使用重量分配會使差異過大,必須用「時間」來分配時,為了維持單一項目的「一致性」,最好的方式就是一開始就放棄重量分配,把這個項目全部統一改用你認為更準確的「時間」作為分配基準。
4. 代表性問題
上面在討論分配到哪裡的時候記得這議題嗎?
舉例:蘿蔔工廠說這100公斤肥料,農民用來生產1000公斤蘿蔔跟500公斤的玉米,其中的蘿蔔30%賣給農會,其他70%賣給其他人,而工廠又跟農會買其中的50%當原料,這個原料會拿來製造ABCDE產品,其中A產品佔20%,最後生產了1000個A產品。
看似沒問題,案例的最後也成功分配了,但你仔細想一下
農民假設有100個呢?
假設供應商不只有農會,他有15個原料供應商呢?
而且不是所有農民跟供應商都會提供你數據資料,他們就算想提供也不一定有資料
先不說全都算要算到天花地老,能不能蒐集齊全本身就是一個大問題。
因此一般PCR也知道如果都要100%納入那基本上就沒辦法算了,所以一般PCR都會說明,你可以抓一定比例的原料當作你的總排放量,每個PCR的規定不同,需要根據PCR去看,假設PCR規定至少要10%的一級數數,然後你可以把這10%的一級數據的平均當成二級數據使用,學術上沒有專有名詞來解釋這個行為,但實務上PCR經常都會寫到這件事情,因此這篇文章我們先用「代表性」去稱呼它(實際上沒這個詞,只是接下來比較好稱呼這個現象),即是你用10%擁有數據平均,來代表全部100%的數據,目的是為了比較好懂。
問題又來了,假設A農民生產的原料量占比剛好是總原料的10%,符合PCR規範,使用了100公升的油,那是不是代表說,實際上這100公升油的平均值,放大到100%就是1000公升?所以你就把所有農民原料的比例都乘以 10 倍當作總活動數據,這樣合理對吧?
但很遺憾答案又錯了,這個看似合理,而且我也相信最後算出來的數字不會算錯,但實務上你的活動數據要佐證,佐證是農民的加油發票100公升油,那活動數據就必須是100公升的油,而且分配的概念上,「只能縮小,不能放大」。所以在分配的欄位裡出現「乘以 10 倍」的動作,很大概率查證員會無法理解並且提出質疑,那不能放大要怎麼計算呢?這個我們用案例說明會比較清楚。
a. 實際算數舉例:
本案工廠從4個供應商共收購1000公斤的原料,且僅有A供應商願意提供數據,產量分別如下:
其中A當年度共生產300公斤,賣給的客戶如下:
而收購1000公斤原料,用於製造的數量如下:
假設A廠商,當年製造時候使用100公升的汽油
A廠商共用了100/3=33.33公升
但放到總原料的部分,A只是1000公斤原料的10%
因此你能推估,工廠當年全部使用的原料
估計會是33.33*10=333.3公升
其中333.3公斤當中,只有200/1000,也就是1/5會用於標的產品
因此最後分配到標的產品的數值就是66.66公升
邏輯上看似沒問題,算出來的結果也相信是正確的
但放到清冊上就出問題了
因為這就是上面說的,分配的定義是「僅能縮小不能放大」
你這乘以10的動作不能叫做分配,所以你不能放到分配原則當中
然後你的原始數據必須是100公升汽油(發票)
所以你也不能在原料就將這10倍給放大
即使你知道工廠該年預估共使用333.3公升的汽油
你也沒辦法用這數字去算,查證員不能理解為什麼會有放大的動作
但你清冊還是必須給算出來,該怎麼算呢?
既然你都知道最終的答案,那不妨試著想100公升如何變成66.66公升你就會發現新天地
原本的計算公式中:
100/3*10/5=66.66
但如果你轉一下,把「100/3*10/5」改成這樣算:
「100 *100 /300 *1000 /100 *200 /1000」=「100/300*200」= 66.66
兩個公式會一樣的,但你就會發現這個數學式當中很多東西可以削除
削一削會發現,變數只有100、300、200,其他的通通都不見了,代表其他的數字放到最終結果計算上是無意義的數字(最終會被削除),包含把10%的一級數據放大到100%當二級預估數據(放大10倍)這件事情,全都是無意義的。
到這邊大家再仔細想想應該就能理解了
也就是說100公升汽油,除以總共生產300公斤得到「每1生產一公斤原料所需的汽油」然後直接乘到最後面,標的產品共用了200公斤,答案就算出來了。
其中PCR上面說的一級數據的平均指的就是這「每1生產一公斤原料所需的汽油」,它就是平均值,PCR說的平均值就是指它,一般新手常常會取平均後,再乘以總量回去預估總共排了多少,但後面算單一產品時候這個總量其實又會被削掉除回去了,因此你取得平均後只要直接乘以最後產品標的的使用量,答案就出來了,千萬不要落入思考誤區。
至於中間誰用了幾%,總共是多少、共有幾個供應商通通都可以忽略,有幾個產線,每個產線佔了幾%通通都是阻礙你思考的雜訊,就算你真的辛苦蒐集這些數據用於運算,但最終都會被削除等於白蒐集了,而計算上他就這麼麼簡單,但計算邏輯有想清楚,這才是最難的,當然因為這是簡化案例比較好懂,實務上更複雜,例如有農民有30個,產品線共15個,這種複雜狀況,那就一定會常常碰到打結的情況,因此如果你看到PCR上面有寫說:「多個地點可以用部分原料的一級數據平均當作二級數據」相關的文字時,不妨思考一下上面說的簡化案例,再去對你的計算邏輯,答案就出來了。
b. 重要原料取得/重要製造地點 的定義:
一般來說定義都是放在前面說的,但我拉到這邊說明是因為要接續上面代表性議題討論,你要先能理解PCR上面說「所謂一級數據平均」當中的「平均」是指什麼後,才能接續思考這問題。
我們先假設今天看到的PCR是說:
【若原料地點超過3處,則可以取重要原料地點之一的一級數據平均值做為所有其他地點的二級數據,惟重要原料地點總量必須超過10%】好了問題來了
我們拿剛剛的案例來用,這個「重要原料」是指下面哪個?
財務提供的全年鋼鐵購買紀錄:共1000公斤的鐵,分別如下
其中A鐵廠可提提供他們製造原料的數據,符合PCR超過10%規範,因此我們只需要A鐵廠提供的數據就能計算,不用BCD供應商提供任何數據。
製造紀錄:
其中X產品的生產紀錄中,它有紀錄生產的原料是哪個工廠來的,即使最後生產的最終產品是一樣的,但30公斤顯然就沒有達到PCR10%的要求。
問題來了,PCR上面說的「重要原料地點&總量必須超過10%」是指哪一個?是不是可以選對自己有利的拿來計算呢?
答案是:都要符合!
也就是你只有A鐵廠的數據是不夠的,你還得想辦法要到B鐵廠的數據,這個問題在查證實務上常常碰到,有經驗的查證員馬上就會進行驗算然後提出質疑,因為PCR沒寫清楚定義的情況下(一般也不會寫清楚),以查證員的視角,查證員就如同會計師,它要審視你完全符合PCR規範,然後要如同會計師簽名,查證員要也要保證簽名,那他們的立場就是通通都要符合。
5. 佐證資料
跟前面的活動數據一樣,你需要分配的比例都要佐證資料,比如說A產品只佔用電的20%,那為什麼是20%它就需要佐證資料,而且分配可能是複數的,就是先乘以30%在乘以50%在乘以20%這樣分配下去,每個環節都需要佐證資料,而且你要把它放到資料夾分類好,以免查證員問的時候找不到,這看似很簡單,但實務上常常會忘記的步驟,而且資料量非常龐大,時常一個資料夾分類沒分類好,要找佐證資料就要找很久。
步驟七:尋找排放係數
活動數據與分配都算出來了,最後就是需要找到係數,然後相乘就得到碳排了對吧,那活動數據在哪裡找呢?其實這一點都不難,基本上也只有兩種方式。
1. 國內數據:環境部碳足跡資訊網
只要是台灣的案子,請最優先使用環境部公告的係數。只要是有國內係數不用,跑去用國外的,一定會被查證員問為什麼。
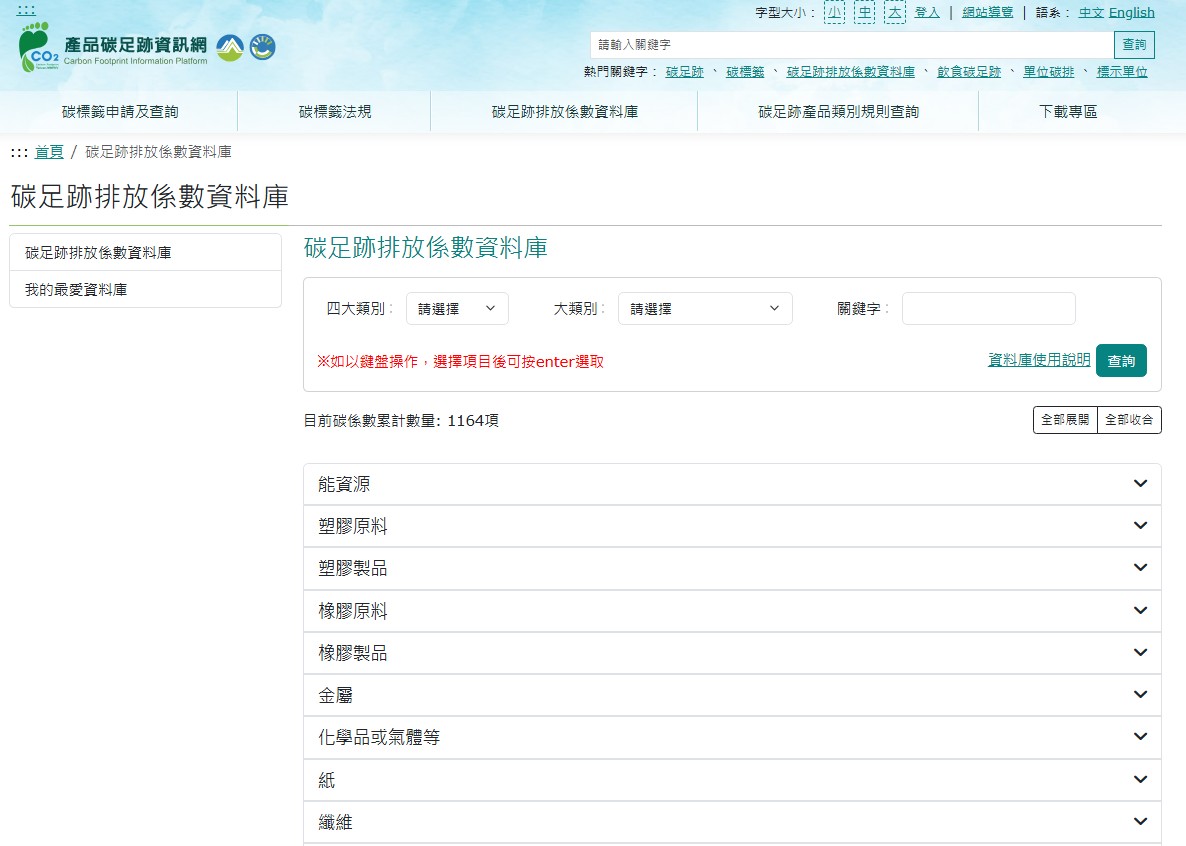
基本上台灣的碳足跡,在這邊可以找到80%以上的係數,甚至簡單一點的案子可能可以找到100%的係數,配合上面的活動數據&分配,Excel公式一相乘,碳排量就直接算出來。
2. 國外資料庫
如果國內找不到,我們只能向外求援。可以尋找公信力機構發布的論文,或是使用國際資料庫: 如 Ecoinvent (瑞士)、Sphera 等,但要注意的是,查證員基本上是優先承認國際資料庫而不是論文的,論文一般都是真的國內外資料庫查不到了才使用,而且論文的碳排計算不一定是你所需要的生命週期範圍,比如它只有製造碳排沒有原料,這時候跟查證員佐證就會比較麻煩。
這時候實務案例上都是使用國際資料庫,但國際資料庫都要錢的,而且不便宜,很少公司會花錢購買資料庫,因為一般公司不是天天在計算碳足跡,就算有也是先嘗試一個產品,慢慢的在拓展到公司其他生產線的產品,花大錢去買軟體授權是多數國內公司不願意的,可是找論文嘛就像上面說的多數情況都會被退回,因為查證員都知道這東西資料庫就有,以查證員的立場,他們更偏向保證資料庫上的數據而不是論文的數據,最後導致光買資料庫的成本可能就超過你去外面找一個顧問做全部盤查的費用了,這也是為什麼14064軟體很多很好賣,而14067軟體卻這麼少的原因之一,而且外面很多賣14067軟體的廠商還沒有附資料庫或需要額外加錢,所以如果有打算買14067軟體的公司記得要先問清楚包含什麼跟不包含什麼,只能言盡於此,再多說就是擋人財路了。
3. 國際資料庫軟體
很多人在填寫清冊時,係數來源會寫資料庫軟體「SimaPro」,但要注意這是錯誤的! SimaPro 或 GaBi 本質上是「生命週期評估軟體」,它們像是運算引擎,裡面搭載了 Ecoinvent 等龐大資料庫。你在 SimaPro 查到的係數,填寫到清冊上面的時候,來源應該填寫「Ecoinvent 3.x 版」,而不是軟體名稱。
至於資料庫如何使用,那又是另一個需要花時間介紹的文章了,這邊就不說明了,只簡單介紹一下如果你有機會操作資料庫軟體,不是像google打好關鍵字就好了,因為你會發現同一個項目它有很多選項,以 SimaPro 查詢為例,當你搜尋R22冷媒好了,你搜尋R22的英文專有名詞Chlorodifluoromethane,除了這個詞本身,後面連接一大堆符號跟英文字,每一個都是不同的項目,這時候你得看得懂才不會選錯。
一般首先要先選區域,常見的縮寫代表的意思是:
而如果搜尋出來有亞洲的係數,以區域相似性來說當然要優先於全球,沒有就用全球,再沒有才用其他地區。
再來選範圍
- Production (生產): 僅包含在「工廠門內」生產該物質的排放。
- Market for (市場): 包含 生產 + 全球/地區平均運輸(卡車/船) + 批發過程中的損耗。
通常做產品碳足跡時,原料要選擇 Market for 會比較完整,因為他代表搖籃到大門,剛好接你的產品繼續計算
再來選擇分配模型
Cut-off : 最常選的模型,一般沒意外計算「原料」的時候都選這個,才不會出現重複計算的問題。
APOS: 偶爾會選擇,他主要是將排放分配給所有副產品。
例如今天原料是牛肉,在屠宰牛的時候會有副產品:皮革、骨粉兩種
皮革通常會分到一點碳排,骨粉通常是回收再利用,這時候用APOS就是不管你,全部分攤
同樣牛的產品如果是Cut-off,計算上會以重量或者最終處理方式分攤,那牛肉就會是最多,骨粉因為生物再利用會分到幾乎為零的排放,差異在這邊。
Conseq: 極少選擇,他是後果性模型,用來分析「當多生產一個產品時,對全球供應鏈產生的邊際影響」,通常用於政府決策、政策評估。
舉例:假設台積電想多蓋一座廠要多用一億度電,而當年在全台灣再生能源產量固定下,台電要多發電只能多燒一點煤或天然氣,那最終台積電多蓋一座廠會不會導致國家電力排放係數增加0.01? 而選這個係數就是要算這個的,所以一般來說說單純算碳排不會選他。
最後就選系統邊界
S (System): 已經幫你算好的結果。
U (Unit): 單元過程。可以看到完整的供應鏈階層(如電力、運輸、原料),像給妳食譜和食材,你可以進去修改細節。
懶人包
「台灣通常選 GLO 或 RoW,除非有特定的亞洲數據,然後選當中的Cut-off S」,絕大多數情況下出來的就是你要的係數數字。
不過最後都選好輸出前,很多人在「方法」的地方,會忘記選GWP100的排放量(重要)
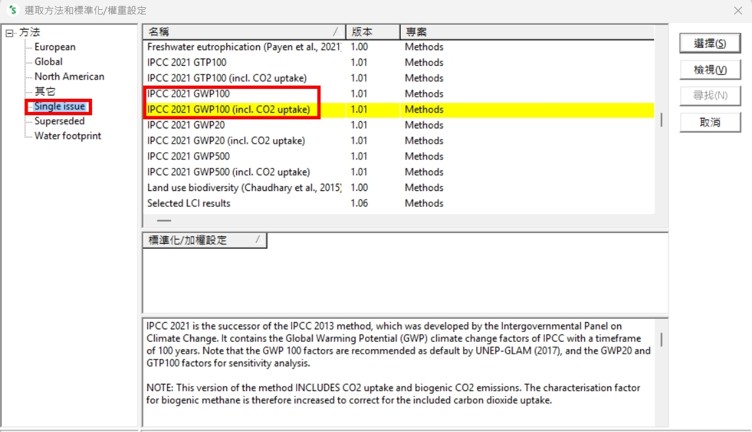
一般是選GPW100就好,至於GPW100 (incl. CO2 uptake)代表它考慮二氧化碳的吸收量,例如植物在生長過程中透過光合作用「吸收」的碳。
顧問總結
碳足跡的計算過程遠比一般組織盤查難,因為他就像是在拼一張幾千片的拼圖。每一個單據、每一個分配公式、每一個係數的選用、每一個佐證資料,都在考驗你的耐心與邏輯。但只要記住「原始數據不變造、分配邏輯要一致、係數來源要明確」,掌握這三點,除了麻煩一點外通常都能扛的過去。
在下一篇文章中,我們將繼續深挖「清冊與報告書」相關的介紹!
如果貴公司正為了複雜的分配邏輯或係數查詢傷透腦筋,也歡迎隨時聯繫我們顧問公司進行協助。